PhysBrain 1.5는 시각과 언어를 처리하는 수준을 넘어 물리 환경 이해, 행동 생성, 미래 상태 예측을 단일 모델에 통합하려는 연구입니다.
이번 연구는 성능 수치와 플랫폼 반응을 구분해 읽을 필요가 있어요.
Hugging Face Daily Papers의 PhysBrain 1.5 게시 페이지(huggingface.co/papers/2609.14973)에는 이 연구가 2026년 9월 14일 게시됐으며, 당시 순위는 24위이고 upvotes는 169로 제시됐습니다.
사전조사에서는 같은 페이지의 upvote가 172로 확인됐으므로, 이 수치는 고정된 연구 성과가 아니라 이용자 반응에 따라 달라지는 표시로 봐야 해요.
기준일은 2026년 9월 16일 04시 35분이며, 게시 순위와 upvote의 유효기간은 확인할 수 없어 이후에도 같은 값이 유지된다고 단정할 수 없어요.
핵심은 인기 지표와 연구 성능을 분리해서 읽는 것입니다.
8B 단일 모델에 물리 이해·행동 생성·미래 예측 통합
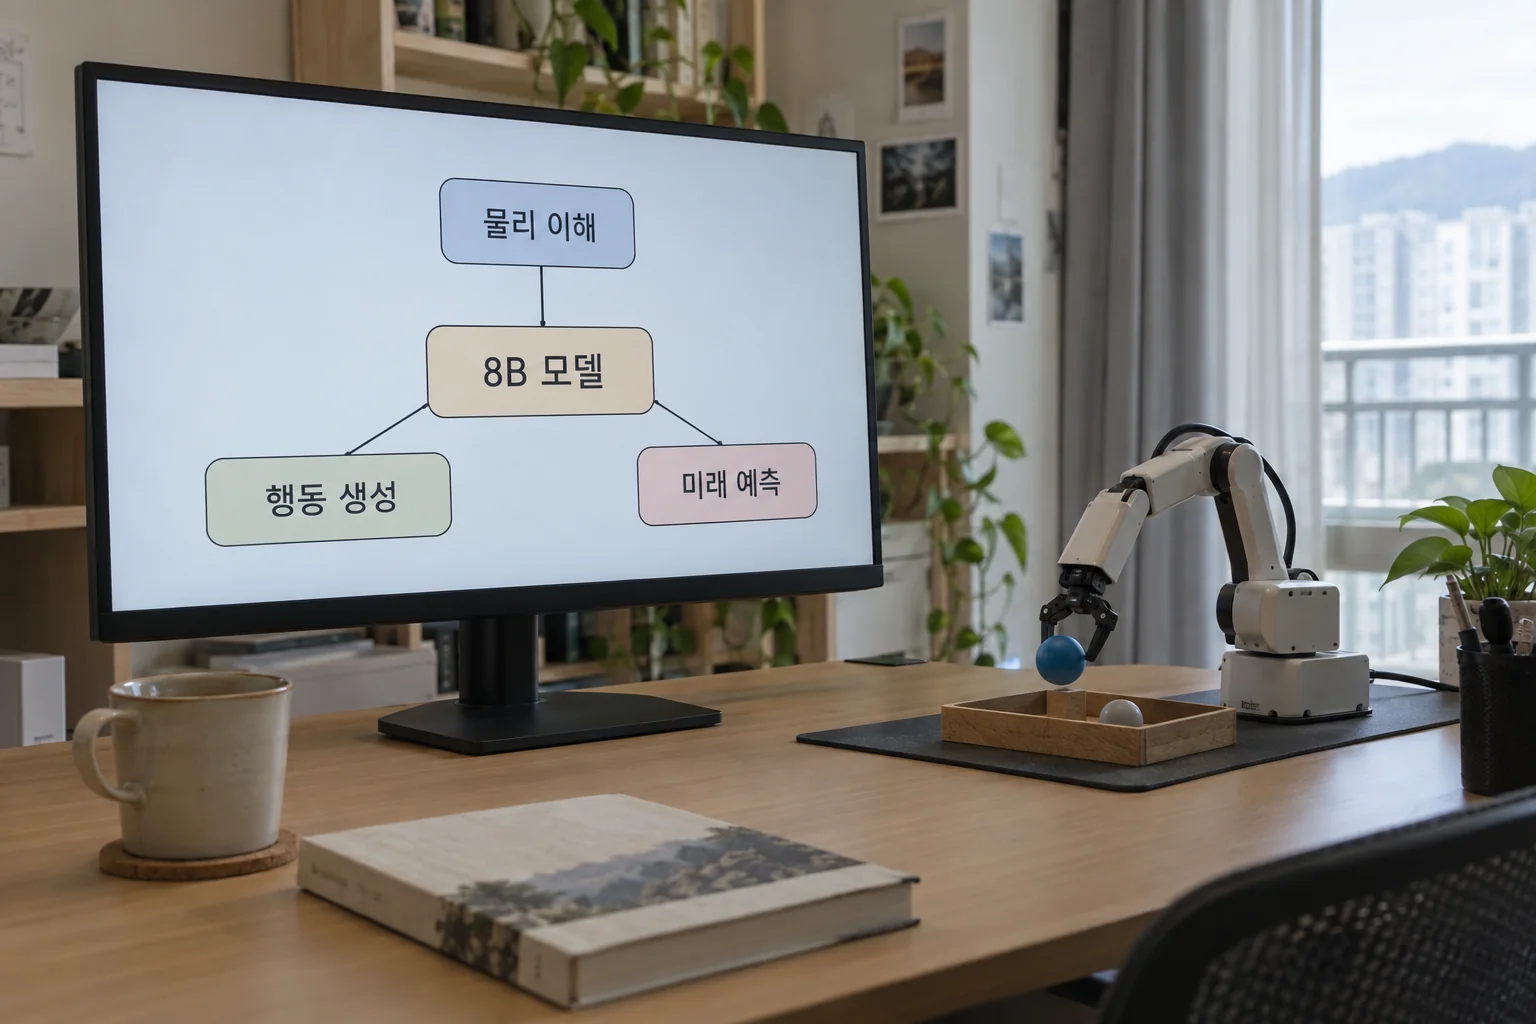
이 연구의 구조적 특징은 물리 환경 이해, 행동 생성, 미래 상태 예측을 단일 8B 모델로 묶었다는 점입니다.
기존의 비전 언어 모델이라는 표현은 이미지나 장면을 언어와 연결해 해석하는 기능에 초점을 두지만, PhysBrain 1.5가 내세우는 물리 기반 모델은 해석 이후의 행동과 상태 변화까지 하나의 범위로 다뤄요.
즉, 무엇이 보이는지를 설명하는 데 그치지 않고 어떤 행동을 만들며 그 뒤 상태가 어떻게 달라질지를 함께 처리하려는 구성이지요.
PhysBrain 1.5 논문 초록과 연구 정보(arxiv.org/abs/2609.14973)는 이런 전환을 비전 언어 모델에서 물리 파운데이션 모델로 확장하는 방향으로 제시해요.
제목의 변화 자체가 연구 범위의 확대를 압축해서 보여주네요.
여기서 8B는 모델 규모를 나타내는 확인 항목이지만, 이 숫자만으로 실제 사용 환경의 속도나 비용을 판단할 수는 없어요.
제공된 자료에는 구동 장비, 처리 시간, 전력 사용량, 이용 가격이 제시되지 않았기 때문입니다.
따라서 생활경제 관점에서 8B를 곧바로 저비용이나 고비용으로 번역해서는 안 돼요.
확인 가능한 사실은 서로 다른 물리 관련 기능을 하나의 8B 모델에 통합했다는 데까지입니다.
가계나 개인 이용자가 부담할 구체적인 비용은 판단 범위 밖입니다.
28개 벤치마크 평균 72.5점과 14개 항목 1위의 범위
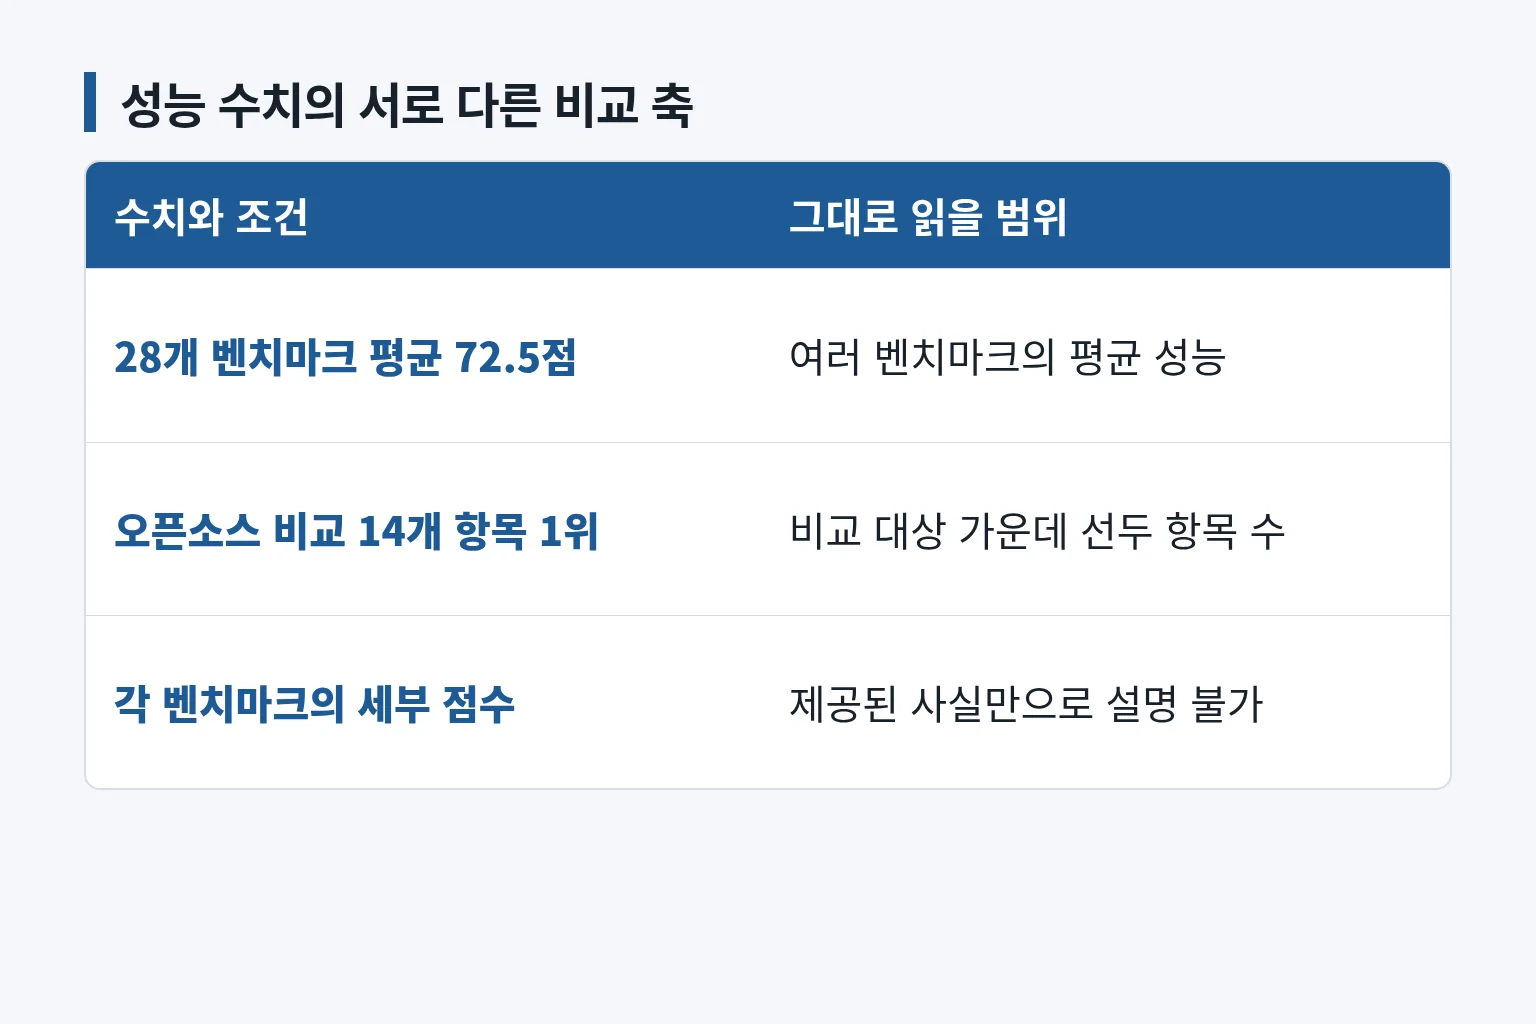
성능 수치의 직접적인 답은 28개 벤치마크 평균 72.5점이며, 오픈소스 비교에서 14개 항목 1위라는 내용은 저자 주장이라는 것입니다.
두 숫자는 서로 다른 비교 축을 나타냅니다.
72.5점은 여러 벤치마크의 평균 성능이고, 14개 항목 1위는 비교 대상 가운데 선두로 제시된 항목 수입니다.
그러므로 72.5점이 14개 항목에서 얻은 평균이라고 바꾸어 읽거나, 모든 평가에서 1위라고 확대해서는 안 되겠죠?
수치가 적용되는 범위를 그대로 유지하는 것이 중요해요.
평균은 28개 벤치마크의 결과를 하나의 값으로 압축하므로 개별 벤치마크별 강점과 약점을 직접 보여주지는 않아요.
또한 14개 항목 1위라는 표현에는 오픈소스라는 비교 조건이 붙습니다.
비교 조건을 빼면 평가 대상의 범위가 달라져 원래 주장보다 넓은 의미가 됩니다.
PhysBrain 1.5 공개 저장소(github.com/DeepCybo-PhysAI/PhysBrain-1.5)는 연구의 공개 자료를 확인할 수 있는 출처이지만, 제공된 사실만으로는 각 벤치마크의 세부 점수나 비교 모델 목록까지 설명할 수 없어요.
평균 점수, 평가 개수, 1위 항목 수, 오픈소스 조건을 한 묶음으로 확인해야 하는 이유입니다.
게시 순위 24위와 upvote 169·172는 연구 성능과 다른 지표
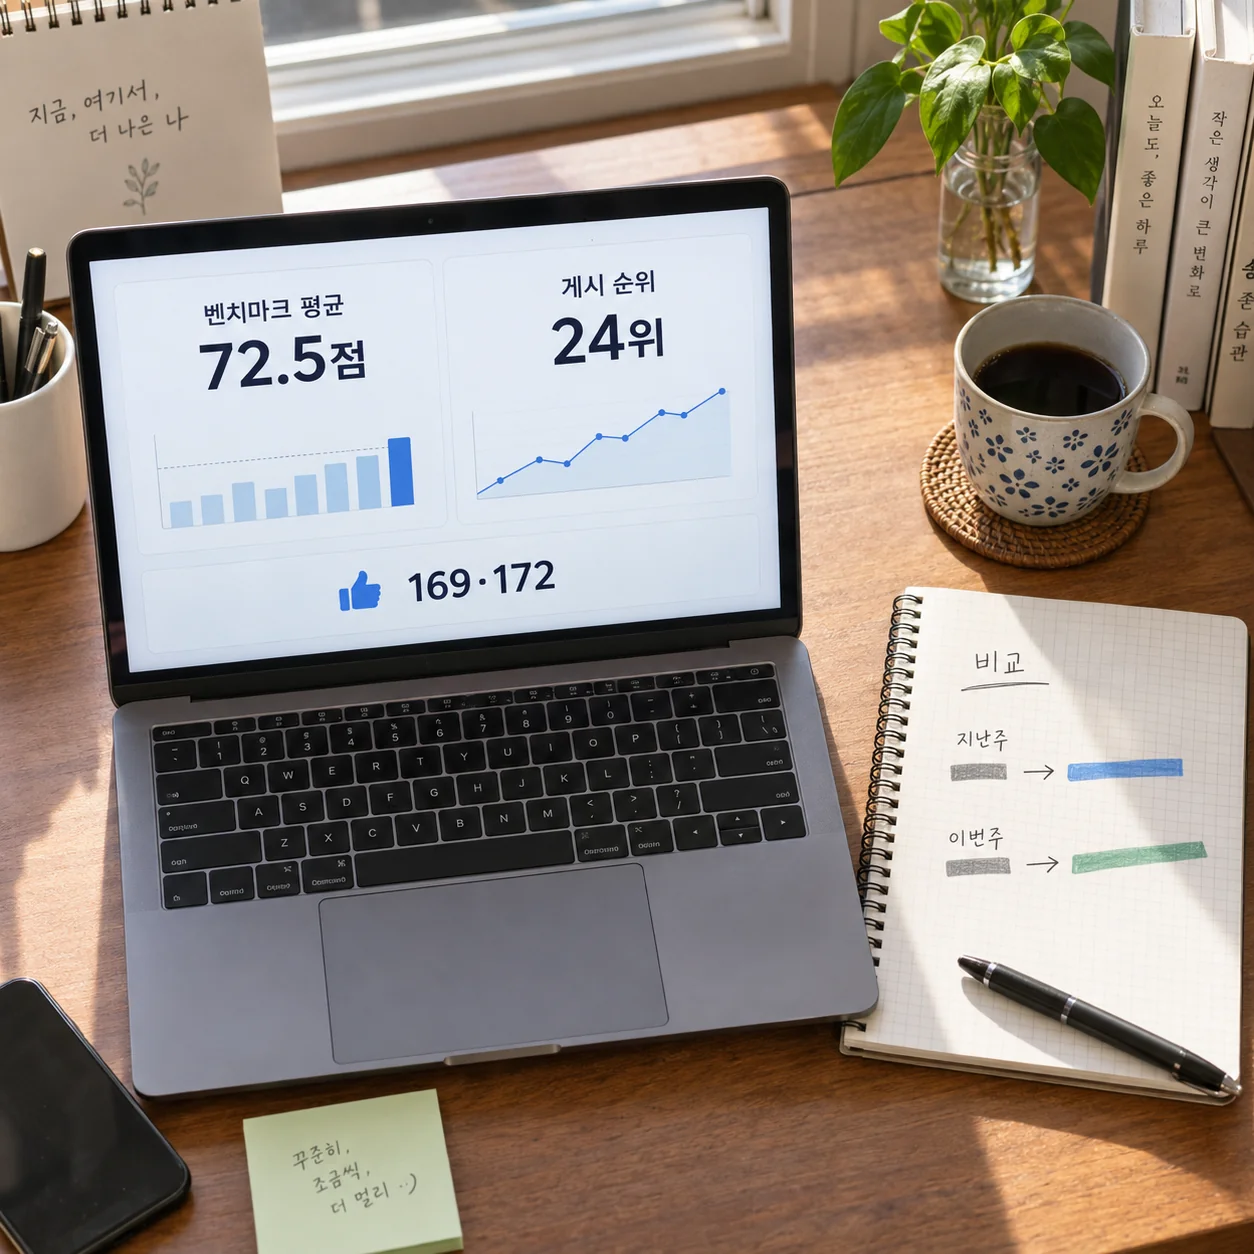
Hugging Face Daily Papers의 24위와 upvote 169는 2026년 9월 14일 게시 당시의 노출 및 이용자 반응 정보이며, 모델의 정확도나 물리 추론 성능 점수가 아닙니다.
사전조사에서 upvote 표기가 172로 달라진 점은 반응 수가 변동할 수 있음을 보여줘요.
169와 172 가운데 하나를 영구적인 대표값으로 고정하기보다 어느 시점에 확인한 값인지 함께 읽어야 하지요.
반면 28개 벤치마크 평균 72.5점은 논문에서 제시한 평가 결과이므로 upvote와 성격이 다릅니다.
인기도와 성능의 구분입니다.
판단 순서는 먼저 Daily Papers의 게시일과 순위를 확인하고, 다음으로 upvote가 시점에 따라 변하는 값인지 살핀 뒤, 마지막으로 논문의 평가 수치와 저자 주장 범위를 따져보는 방식이 적절해요.
이 순서를 따르면 24위라는 순위가 연구 전체의 학술적 서열인 것처럼 읽히는 혼동을 줄일 수 있어요.
또한 upvote가 169에서 172로 바뀌었다고 해서 벤치마크 평균 72.5점까지 달라졌다고 볼 근거도 없어요.
게시 플랫폼의 반응 지표와 연구자가 보고한 성능 지표는 출처와 의미가 각각 다르기 때문입니다.
숫자가 가까이 배치돼 있어도 같은 잣대는 아닙니다.
생활경제 영향은 활용 가능성과 비용 정보의 분리에서 판단
현재 제공된 자료로 확인할 수 있는 생활경제적 의미는 물리 환경을 이해하고 행동과 미래 상태까지 다루는 통합 모델 연구가 공개됐다는 사실입니다.
이 방향은 비전 언어 모델의 역할을 장면 설명에서 물리적 변화와 행동 처리로 넓히려는 흐름을 보여줘요.
다만 개인의 지출 절감액, 서비스 가격, 업무 시간 감소분, 제품 출시 일정은 소재에 없습니다.
따라서 이 연구가 곧바로 가계 비용을 낮추거나 특정 직무를 대체한다고 결론 내릴 수는 없겠지요.
연구 방향과 확정된 생활 효과를 구별해야 해요.
실제로 확인할 항목은 모델 규모가 8B인지, 세 기능이 단일 모델에 통합됐는지, 평가가 28개 벤치마크를 대상으로 했는지, 평균이 72.5점으로 제시됐는지입니다.
이어 오픈소스 비교 14개 항목 1위가 저자의 주장이라는 조건을 확인해야 해요.
판단 단계에서는 이 수치들이 실제 이용 비용이나 개인용 장비에서의 성능을 뜻하지 않는다는 점을 먼저 적용하는 편이 안전해요.
그다음 공개 논문과 저장소를 통해 연구 범위를 살피고, Daily Papers의 순위와 upvote는 관심도 지표로만 구분하면 됩니다.
확인 항목은 사실의 일치 여부를 다루고, 판단 순서는 그 사실을 어디까지 생활 영향으로 해석할지를 다룬다는 차이가 있어요.
이 연구를 생활 정보로 읽을 때 가장 중요한 변화는 인공지능의 평가 대상이 시각과 언어의 연결에서 물리 환경의 이해, 행동 생성, 미래 상태 예측의 결합으로 넓어졌다는 점입니다.
그러나 단일 8B 모델이라는 구조와 72.5점이라는 평균만으로 이용 문턱을 계산할 수는 없어요.
생활에 직접 영향을 주는지 판단하려면 가격, 접근 방식, 필요한 장비, 실제 제공 형태가 추가로 제시돼야 하지만 해당 정보는 제공된 소재에서 확인되지 않아요.
현재 단계에서 읽을 수 있는 것은 연구의 방향, 공개된 평가 규모, 저자 주장의 범위, 플랫폼 반응의 변동성까지입니다.
그 이상을 비용 효과나 시장 전망으로 확장하지 않는 것이 수치에 맞는 해석입니다.
함께 읽기